Pour l'ordinateur, un texte est une suite de nombres : à chaque caractère correspond un code, stocké sur un ou plusieurs octets.
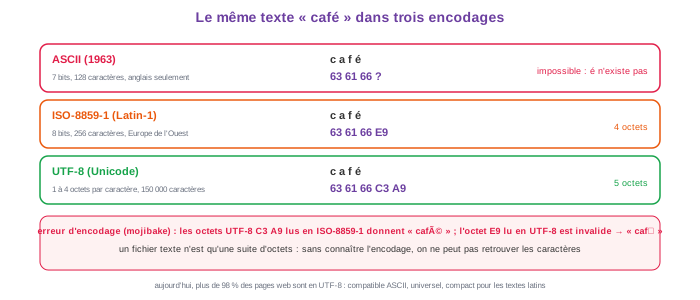
La table qui associe caractères et codes s'appelle un encodage. Il en existe plusieurs, nés à des époques différentes : ASCII, ISO-8859-1, puis Unicode et son encodage UTF-8.
caractères de contrôle : tabulation (9), saut de ligne (10), retour chariot (13)
32
espace
33 à 47
ponctuation : ! (33), , (44), . (46)
48 à 57
chiffres 0 à 9
65 à 90
majuscules A (65) à Z (90)
97 à 122
minuscules a (97) à z (122)
En Python, ord donne le code d'un caractère, et chr fait l'inverse.
print(ord("A"), ord("a"), ord("0"))
print(chr(65), chr(97), chr(48))
for c in"NSI !":
print(c, ord(c), bin(ord(c)))
Un caractère ASCII tient sur un octet dont le bit de poids fort vaut 0.
defmajuscule(c):
# à toireturn c
1.2 Une application : le chiffrement de César
Puisque les lettres sont des nombres, on peut calculer avec. Le chiffrement de César décale chaque lettre de d positions dans l'alphabet.
defcesar(texte, d):
"""Décale chaque lettre majuscule de d positions (chiffrement de César)."""
resultat = ""for c in texte:
if"A" <= c <= "Z":
resultat = resultat + chr((ord(c) - 65 + d) % 26 + 65)
else:
resultat = resultat + c
return resultat
secret = cesar("RENDEZ-VOUS A MIDI", 3)
print(secret)
print(cesar(secret, -3))
1.3 Les limites
2. ISO-8859-1 : un octet complet
Avec le 8e bit, on dispose de 256 codes.
Un caractère occupe toujours un octet : cela reste simple.
3. Unicode et UTF-8 : un code pour tous les caractères
3.1 Unicode : le répertoire
Plus de 150000 caractères sont définis. Les 128 premiers points de code sont ceux de l'ASCII, les 256 premiers ceux d'ISO-8859-1.
for c in"Aé€中😀":
print(c, ord(c), hex(ord(c)))
3.2 UTF-8 : un encodage à longueur variable
UTF-8 code chaque point de code sur 1 à 4 octets, selon sa taille.
Point de code
Octets
Forme binaire
Exemples
U+0000 à U+007F
1
0xxxxxxx
ASCII : A, 1, !
U+0080 à U+07FF
2
110xxxxx 10xxxxxx
é, ç, grec, cyrillique
U+0800 à U+FFFF
3
1110xxxx 10xxxxxx 10xxxxxx
€, chinois, japonais
U+10000 à U+10FFFF
4
11110xxx 10xxxxxx 10xxxxxx 10xxxxxx
émojis 😀
Les bits de préfixe du premier octet (0, 110, 1110, 11110) annoncent la longueur. Chaque octet de continuation commence par 10. Les x reçoivent les bits du point de code.
Vérifions, et regardons les octets d'autres caractères.
for c in"Aé€😀":
octets = c.encode("utf-8")
print(c, len(octets), "octet(s) :", [bin(o) for o in octets])
3.3 Pourquoi UTF-8 s'est imposé
Atout
Explication
compatible ASCII
un texte ASCII est déjà de l'UTF-8 valide : un seul octet, bit de poids fort à 0
universel
tous les caractères de toutes les langues, sans variantes régionales
compact
pour les langues latines, surtout des caractères à 1 ou 2 octets
robuste
un octet 10xxxxxx est toujours une continuation : on se resynchronise facilement
Plus de 98% des pages web sont en UTF-8. C'est l'encodage par défaut de Python 3, du HTML5, de Linux et de macOS.
mot = "café"print(len(mot), "caractères")
print(len(mot.encode("utf-8")), "octets en UTF-8")
print(len(mot.encode("latin-1")), "octets en Latin-1")
deftaille_utf8(texte):
octets = 0for c in texte:
octets = octets + 1# à corriger : tous les caractères ne font pas 1 octetreturn octets
4. Erreurs d'encodage et conversions
4.1 Le mojibake
Si un programme lit des octets UTF-8 en croyant à de l'ISO-8859-1, chaque caractère accentué, codé sur deux octets, devient deux caractères.
La dernière ligne décode avec le mauvais encodage : c'est exactement ainsi que naît le mojibake. Fabrique le tien.
texte = "Noël à la crèche"
octets = texte.encode("utf-8") # on écrit en UTF-8print(octets.decode("latin-1")) # on relit en Latin-1 : mojibakeprint(octets.decode("utf-8")) # on relit en UTF-8 : tout va bien
4.3 Convertir un fichier
# On fabrique un vieux fichier en Latin-1 pour l'exemplewithopen("ancien.txt", "w", encoding="latin-1") as f:
f.write("Élève appliqué")
# La conversionwithopen("ancien.txt", "r", encoding="latin-1") as f:
texte = f.read()
withopen("nouveau.txt", "w", encoding="utf-8") as f:
f.write(texte)
# On compare les tailles des deux fichiers, en octetsprint(len(open("ancien.txt", "rb").read()), "octets en Latin-1")
print(len(open("nouveau.txt", "rb").read()), "octets en UTF-8")
Les éditeurs de texte affichent l'encodage en bas de la fenêtre et proposent « réenregistrer avec l'encodage… ». Une page web déclare le sien avec <meta charset="utf-8">.
4.4 Taille d'un texte
La taille en octets est la somme des tailles des caractères.
Un roman de 500000 caractères en français pèse environ 510 ko en UTF-8, car environ 2% des lettres sont accentuées. Il pèserait 1 Mo en UTF-16, à 2 octets par caractère.
5. Exemple résolu pas à pas
Correction · Question a
A=65, donc G=65+6=71=10001112. g=71+32=103=11001112.
Correction · Question b
En ISO-8859-1, un octet par caractère : N=78=4E, o=111=6F, ë=235=EB, l=108=6C.
Soit 4E 6F EB 6C : 4 octets.
En UTF-8, N, o et l sont inchangés.
Pour ë : 235=111010112 est entre 128 et 2047, il faut 2 octets.
Les bits complétés 00011101011 se répartissent en 110 00011 et 10 101011, soit C3 AB.
Résultat : 4E 6F C3 AB 6C, soit 5 octets.
Correction · Question c
Les octets C3 et AB sont lus séparément, comme les caractères Latin-1 de codes 195 (Ã) et 171 («).
On affiche « Noël ».
Correction · Question d
Le programme affiche 4 5 : quatre caractères, mais cinq octets, car ë occupe deux octets en UTF-8.
Vérifie les quatre réponses :
print(ord("G"), bin(ord("G")), ord("g"), bin(ord("g")))
mot = "Noël"print([hex(o) for o in mot.encode("latin-1")])
print([hex(o) for o in mot.encode("utf-8")])
print(mot.encode("utf-8").decode("latin-1"))
print(len(mot), len(mot.encode("utf-8")))
À retenir
Révise ce chapitre avec KlarIA
Tuteur qui t'explique pas à pas, quiz pour t'entraîner, flashcards pour mémoriser. Gratuit.