Statistiques à deux variables
Cours
Statistiques à deux variables
En seconde, on a appris à décrire un caractère à la fois : la moyenne des notes d'une classe, la médiane des salaires, l'étendue des températures. Mais les questions intéressantes portent presque toujours sur deux caractères en même temps : les habitants des villes se déplacent-ils autrement que ceux des campagnes ? La concentration de CO₂ dans l'air augmente-t-elle régulièrement avec le temps ? Un pays plus riche est-il un pays où l'on vit plus longtemps ?
Ce chapitre donne les outils pour croiser deux caractères : un tableau croisé et ses diagrammes quand les caractères sont qualitatifs, un nuage de points et une droite d'ajustement quand ils sont quantitatifs. Les données étudiées sont réelles ou réalistes, comme celles publiées par l'Insee, l'Ined, le Giec ou data.gouv.fr.
1. Croiser deux caractères qualitatifs
1.1 Le tableau croisé d'effectifs
Un caractère est qualitatif quand ses valeurs, appelées modalités, ne sont pas des nombres : le genre, le mode de transport, la mention au bac.
Exemple. On interroge lycéens sur leur lieu d'habitation (ville ou périphérie) et sur leur mode de transport principal pour venir au lycée. Les réponses sont rangées dans un tableau croisé d'effectifs :
| Marche ou vélo | Transports en commun | Voiture | Total | |
|---|---|---|---|---|
| Ville | ||||
| Périphérie | ||||
| Total |
Chaque case intérieure compte les lycéens qui ont les deux modalités à la fois : lycéens habitent en ville et viennent en transports en commun. La dernière ligne et la dernière colonne, appelées marges, donnent les effectifs de chaque caractère pris séparément ; la case en bas à droite est l'effectif total.
Pour vérifier un tableau, on contrôle que chaque ligne et chaque colonne s'additionnent bien jusqu'à sa marge : et .
1.2 Fréquences : la question « parmi qui ? »
Une même case peut se lire de trois façons, selon la population de référence choisie.
- Fréquence globale : , soit des lycéens interrogés habitent en ville et prennent les transports en commun.
- Fréquence conditionnelle en ligne : , soit des citadins prennent les transports en commun.
- Fréquence conditionnelle en colonne : , soit des usagers des transports en commun habitent en ville.
Le numérateur est toujours la case ; c'est le dénominateur qui change : le total général, le total de la ligne ou le total de la colonne. On retrouve exactement la distinction entre , et du chapitre de probabilités.
Pour comparer les deux groupes d'habitants, on calcule le profil de chaque ligne, c'est-à-dire ses fréquences conditionnelles :
| Marche ou vélo | Transports en commun | Voiture | Total | |
|---|---|---|---|---|
| Ville | ||||
| Périphérie |
🎯 Le piège classique. Dans le tableau d'effectifs, citadins prennent les transports en commun contre habitants de la périphérie : on serait tenté de dire que les citadins les utilisent davantage. Mais les deux groupes n'ont pas la même taille ( contre ). En proportion, c'est l'inverse : contre . Pour comparer des groupes de tailles différentes, on compare toujours des fréquences, jamais des effectifs.
1.3 Représenter le croisement
Trois diagrammes sont au programme.
- Le diagramme en barres groupées représente les effectifs : pour chaque lieu d'habitation, trois barres côte à côte, une par mode de transport. Il montre les quantités, mais rend la comparaison des profils difficile quand les groupes n'ont pas la même taille.
- Le diagramme en barres empilées à représente les profils : une barre par groupe, découpée selon les fréquences conditionnelles. C'est le meilleur outil pour comparer des répartitions.
- Le diagramme circulaire représente la répartition d'un seul groupe : un disque pour la ville, un autre pour la périphérie, chaque secteur ayant un angle proportionnel à la fréquence ( de donne ).
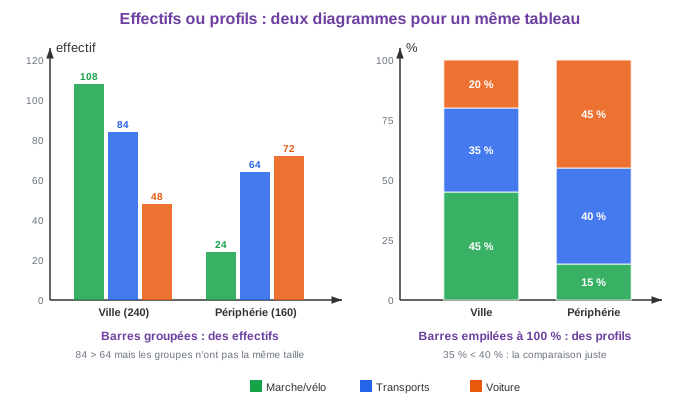
Pour lire un diagramme, on commence toujours par les axes : que représente la hauteur des barres, des effectifs ou des pourcentages ? Quelle est l'unité de graduation ? Une barre deux fois plus haute ne signifie « deux fois plus » que si l'axe part de .
2. Croiser deux caractères quantitatifs
2.1 Série à deux variables et nuage de points
Un caractère est quantitatif quand ses valeurs sont des nombres : une année, une température, un revenu. Une série statistique à deux variables est une liste de couples : à chaque individu (ou à chaque date) correspondent deux nombres.
Exemple. Concentration moyenne de dioxyde de carbone dans l'atmosphère, mesurée à l'observatoire de Mauna Loa (Hawaï), en parties par million (ppm). Pour simplifier les calculs, on note le rang de l'année à partir de et la concentration arrondie à l'unité.
| Année | |||||||
|---|---|---|---|---|---|---|---|
| Rang | |||||||
| Concentration (ppm) |
Le nuage de points est l'ensemble des points placés dans un repère. On ne relie pas les points : chacun est une mesure. La première chose à faire est de décrire la forme du nuage : ici, les points sont presque alignés le long d'une droite qui monte, la concentration augmente régulièrement avec le temps.
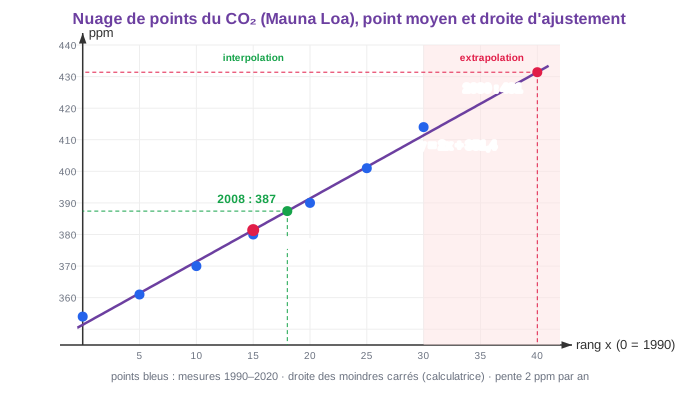
Quand l'un des caractères est le temps, on parle de série chronologique. Choisir comme abscisse le rang de l'année () plutôt que l'année elle-même () évite de manipuler de grands nombres sans rien changer à la forme du nuage.
2.2 Le point moyen
Le point moyen du nuage est le point dont l'abscisse est la moyenne des et l'ordonnée la moyenne des :
Pour la série du CO₂ :
Donc . Le point moyen est le « centre de gravité » du nuage : il ne coïncide généralement avec aucun point de la série, mais il en résume la position. Toutes les droites d'ajustement usuelles passent par lui.
2.3 Ajustement affine
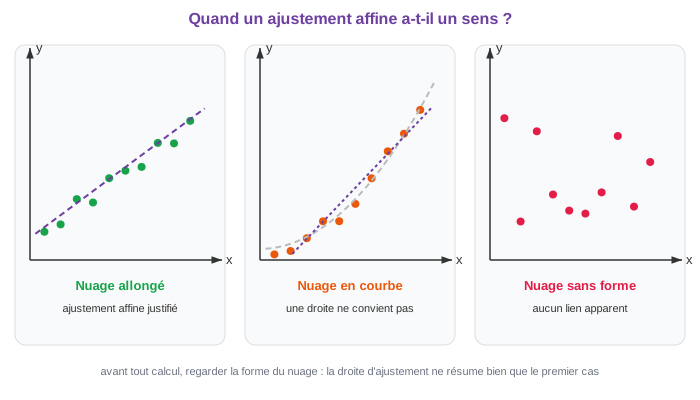
Quand le nuage est allongé autour d'une droite, on peut remplacer les points par une droite d'équation : c'est un ajustement affine. Cette droite est un modèle qui décrit approximativement le lien entre et et permet de faire des estimations. Si le nuage est en forme de courbe ou sans forme particulière, un ajustement affine n'a pas de sens.
Le programme propose trois façons d'obtenir cette droite ; aucune théorie n'est attendue, il faut savoir les utiliser.
Ajustement au jugé. On trace à la règle une droite qui passe par et laisse à peu près autant de points de chaque côté, aussi près d'eux que possible. Pour obtenir son équation, on lit les coordonnées de deux points de la droite (pas forcément des points du nuage) et l'on calcule , puis à l'aide de l'un des deux points.
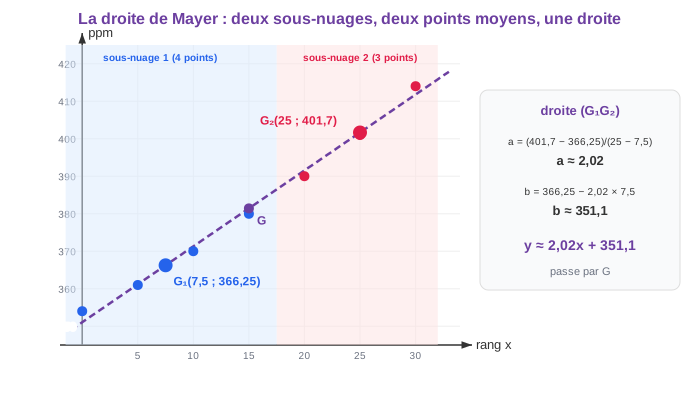
Droite de Mayer. On partage le nuage en deux sous-nuages de tailles voisines, en suivant l'ordre des abscisses ; on calcule le point moyen de chacun, et ; la droite de Mayer est la droite . Pour le CO₂, avec les quatre premiers points puis les trois derniers :
La droite de Mayer a pour équation . Elle passe par , qui est toujours situé sur le segment .
Droite des moindres carrés. C'est l'ajustement que donnent la calculatrice (mode statistiques à deux variables, « régression linéaire ») et le tableur (courbe de tendance). Pour le CO₂, on obtient (coefficients arrondis). On n'a pas à savoir comment elle est calculée, seulement à saisir correctement les deux listes et à lire et .
Les trois méthodes donnent des droites très proches : ici, une pente d'environ ppm par an. Le coefficient directeur a toujours une interprétation concrète : c'est l'augmentation moyenne de quand augmente de . Dire « la concentration augmente d'environ ppm par an » est une lecture attendue.
🎯 Savoir présenter un ajustement. On précise toujours : la méthode utilisée (« au jugé », « droite de Mayer », « obtenue à la calculatrice »), l'équation avec des coefficients arrondis de façon raisonnable, et ce que représentent et avec leurs unités. Une équation sans contexte ne vaut rien.
2.4 Interpoler, extrapoler
Une fois l'équation obtenue, on l'utilise pour estimer des valeurs inconnues.
- Interpolation : estimer une valeur entre deux données connues. En , et : d'après le modèle, la concentration valait environ ppm. La valeur réellement mesurée est ppm : l'estimation est excellente.
- Extrapolation : estimer une valeur en dehors de la plage des données, le plus souvent dans le futur. En , et ppm.
- Problème de seuil : à partir de quelle année dépasserait-on ppm ? On résout , soit . Le seuil serait franchi au cours de la année après , donc vers .
L'interpolation est en général fiable, car le modèle est utilisé là où il a été construit. L'extrapolation suppose que la tendance se poursuit, ce qui n'est jamais garanti : plus on s'éloigne des données, moins l'estimation est sûre. Pour le CO₂, la valeur mesurée en est ppm alors que le modèle donne ppm : la croissance réelle s'accélère, la droite sous-estime déjà légèrement.
2.5 Une droite décrit, elle n'explique pas
Un ajustement met en évidence un lien statistique entre deux caractères, pas une cause. Dans une station balnéaire, les ventes de glaces et le nombre de noyades sont liés par une belle droite croissante : ce n'est pas la glace qui noie, c'est la chaleur qui fait à la fois vendre des glaces et remplir les plages. Face à un nuage bien aligné, la bonne question est toujours : quel mécanisme relie les deux caractères, et existe-t-il un troisième facteur caché ?
3. Avec un tableur
Le programme demande de savoir utiliser un tableur pour représenter les données et obtenir l'ajustement. Avec les rangs en colonne A (cellules A2 à A8) et les concentrations en colonne B :
| Objectif | Ce que l'on fait |
|---|---|
| Coordonnées du point moyen | =MOYENNE(A2:A8) et =MOYENNE(B2:B8) |
| Nuage de points | Sélectionner A1:B8, insérer un graphique de type « nuage de points (XY) » |
| Droite des moindres carrés | Clic droit sur le nuage, « ajouter une courbe de tendance », type linéaire, cocher « afficher l'équation » |
| Coefficients sans le graphique | =PENTE(B2:B8;A2:A8) pour et =ORDONNEE.ORIGINE(B2:B8;A2:A8) pour |
| Estimation pour | =2*40+351,4, ou directement =PREVISION(40;B2:B8;A2:A8) |
Attention à l'ordre des arguments : les fonctions PENTE et ORDONNEE.ORIGINE prennent d'abord les , puis les .
4. Exemple résolu pas à pas
Énoncé. Le tableau donne la population d'une commune, en milliers d'habitants, tous les deux ans.
| Année | |||||
|---|---|---|---|---|---|
| Rang | |||||
| Population (milliers) |
a) Représenter le nuage de points et calculer les coordonnées du point moyen. b) La calculatrice donne la droite des moindres carrés . Vérifier qu'elle passe par et interpréter le coefficient . c) Estimer la population en . d) À partir de quelle année la population dépasserait-elle habitants ?
a) Les points sont presque alignés le long d'une droite croissante : un ajustement affine est justifié.
Le point moyen est .
b) Pour : . La droite passe bien par . Le coefficient directeur signifie que, d'après le modèle, la population augmente en moyenne de millier, soit habitants, par an.
c) En , et . Le modèle prévoit environ habitants. C'est une extrapolation à huit ans des dernières données : une estimation, pas une certitude.
d) On cherche tel que , soit , donc . Comme est un nombre entier d'années, le seuil est franchi pour , c'est-à-dire en . Vérification : et .
🎯 Rédiger un problème de seuil. Trois étapes attendues : écrire l'inéquation à partir du modèle, la résoudre, puis revenir au contexte (année entière, unité, phrase de conclusion). Oublier la dernière étape coûte des points même quand le calcul est juste.
📌 À retenir
- Un tableau croisé d'effectifs croise deux caractères qualitatifs ; ses marges donnent les effectifs de chaque caractère. Une case se lit avec trois dénominateurs possibles : le total général (fréquence globale), le total de la ligne ou de la colonne (fréquences conditionnelles).
- Pour comparer des groupes de tailles différentes, on compare des fréquences, jamais des effectifs. Le diagramme en barres empilées à est fait pour cela.
- Deux caractères quantitatifs se représentent par un nuage de points ; le point moyen est .
- Si le nuage est allongé, un ajustement affine le résume : au jugé, par la droite de Mayer ou par la calculatrice (moindres carrés). Toutes passent par ; est la variation moyenne de quand augmente de .
- Interpoler (entre les données) est fiable ; extrapoler (au-delà) suppose que la tendance continue. Un problème de seuil se résout par une inéquation, puis on revient au contexte.
- Un lien statistique n'est pas une cause : toujours chercher le mécanisme ou le facteur caché.
Révise ce chapitre avec KlarIA
Tuteur qui t'explique pas à pas, quiz pour t'entraîner, flashcards pour mémoriser. Gratuit.
Créer mon compte gratuitement→