Résultats d'un sondage, catalogue d'une bibliothèque, relevé de températures, liste des élèves d'un lycée : beaucoup de données se présentent en table.
Ce chapitre montre comment importer une table depuis un fichier CSV et la représenter en Python par un tableau de dictionnaires.
On apprend ensuite à rechercher des lignes selon des critères, à trier suivant une colonne et à fusionner deux tables.
C'est la préparation, en Python, des bases de données de terminale.
1. Une table et ses descripteurs
1.1 Vocabulaire
nom
ville
age
note
Diallo
Lyon
16
15
Martin
Paris
17
9
Nguyen
Lyon
16
18
Rossi
Nice
15
12
1.2 Représentation en Python
Une ligne est un p-uplet nommé, donc un dictionnaire.
Un fichier texte tabulé est identique, avec des tabulations comme séparateurs. Les tableurs exportent dans ces deux formats.
2.2 Lire le fichier
Il y a deux façons de lire un fichier CSV : à la main, pour comprendre, ou avec le module csv, pour aller vite.
À la main
deflire_csv(nom_fichier):
"""Renvoie un tableau de dictionnaires ; toutes les valeurs sont des chaînes."""withopen(nom_fichier, "r", encoding="utf-8") as f:
lignes = f.readlines()
descripteurs = lignes[0].rstrip("\n").split(",")
table = []
for ligne in lignes[1:]:
valeurs = ligne.rstrip("\n").split(",")
enregistrement = {}
for i inrange(len(descripteurs)):
enregistrement[descripteurs[i]] = valeurs[i]
table.append(enregistrement)
return table
Avec le module csv
import csv
withopen("eleves.csv", "r", encoding="utf-8") as f:
table = list(csv.DictReader(f))
Dans la lecture à la main, rstrip("\n") retire le saut de ligne final et split(",") découpe la ligne.
Avec le module csv, DictReader lit la première ligne comme descripteurs et renvoie un dictionnaire par ligne.
Essayons. Les premières lignes du bloc créent le fichier eleves.csv, pour avoir quelque chose à lire.
# On crée le fichier pour l'exemplewithopen("eleves.csv", "w", encoding="utf-8") as f:
f.write("nom,ville,age,note\nDiallo,Lyon,16,15\nMartin,Paris,17,9\nNguyen,Lyon,16,18\n")
# La lecture proprement diteimport csv
withopen("eleves.csv", "r", encoding="utf-8") as f:
table = list(csv.DictReader(f))
for e in table:
print(e)
Regarde bien l'affichage : l'âge est '16', entre guillemets.
defdoublons(table, cle):
"""Renvoie les valeurs de la colonne cle présentes plus d'une fois."""
vus = {}
resultat = []
for e in table:
v = e[cle]
if v in vus and v notin resultat:
resultat.append(v)
vus[v] = Truereturn resultat
table = [
{"nom": "Diallo", "note": 15},
{"nom": "Martin", "note": 9},
{"nom": "Diallo", "note": 11},
]
print(doublons(table, "nom"))
defnotes_invalides(table):
noms = []
# à toireturn noms
3. Rechercher dans une table
3.1 Sélectionner des lignes
3.2 Combiner des critères
Les critères se combinent avec and, or et not.
table = [
{"nom": "Diallo", "ville": "Lyon", "age": 16, "note": 15},
{"nom": "Martin", "ville": "Paris", "age": 17, "note": 9},
{"nom": "Nguyen", "ville": "Lyon", "age": 16, "note": 18},
{"nom": "Rossi", "ville": "Nice", "age": 15, "note": 12},
]
lyonnais = [e for e in table if e["ville"] == "Lyon"]
print(len(lyonnais), "élèves à Lyon")
selection = [e for e in table if e["ville"] == "Lyon"and e["note"] >= 16]
for e in selection:
print(e["nom"], e["note"])
Remplace le critère par e["age"] == 17 or e["note"] < 10, puis par not (e["ville"] == "Paris").
3.3 Projeter, compter, agréger
Opération
Ce qu'on veut
En Python
projection
garder certaines colonnes
[e["nom"] for e in table]
comptage
combien de lignes conviennent
len([e for e in table if e["ville"] == "Lyon"])
existence
y a-t-il au moins une ligne
une boucle qui renvoie True dès qu'une ligne convient
maximum
la meilleure ligne
un parcours qui garde la meilleure ligne rencontrée
table = [
    {"nom": "Diallo", "ville": "Lyon", "note": 15},
    {"nom": "Martin", "ville": "Paris", "note": 9},
    {"nom": "Nguyen", "ville": "Lyon", "note": 18},
]

print([e["nom"] for e in table])

meilleur = table[0]
for e in table:
    if e["note"] > meilleur["note"]:
        meilleur = e
print("meilleure note :", meilleur["nom"])
defadmis(table, seuil):
# à toireturn []
4. Trier une table
4.1 La fonction sorted et le paramètre key
Trier une table, c'est ordonner ses lignes suivant une colonne.
Les trois élèves de Lyon sont regroupés, et classés par note à l'intérieur du groupe. Inverse les deux éléments du p-uplet, et observe la différence.
5. Fusionner deux tables
5.1 Un descripteur commun
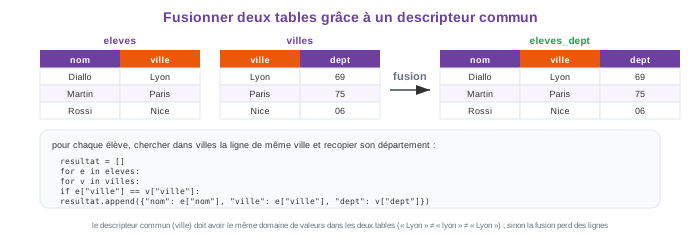
Quand deux tables partagent un descripteur (la ville, un identifiant), on peut construire une nouvelle table qui combine leurs colonnes.
Pour chaque ligne de la première table, on cherche la ligne correspondante dans la seconde.
eleves = [
{"nom": "Diallo", "ville": "Lyon"},
{"nom": "Martin", "ville": "Paris"},
{"nom": "Rossi", "ville": "Nice"},
]
villes = [
{"ville": "Lyon", "dept": "69"},
{"ville": "Paris", "dept": "75"},
{"ville": "Nice", "dept": "06"},
]
deffusion(eleves, villes):
resultat = []
for e in eleves:
for v in villes:
if e["ville"] == v["ville"]:
resultat.append({"nom": e["nom"], "ville": e["ville"], "dept": v["dept"]})
return resultat
for ligne in fusion(eleves, villes):
print(ligne)
Écris "lyon" sans majuscule dans la table villes, puis relance : que devient Diallo ?
5.2 Domaine de valeurs et pièges
Il existe deux autres façons de combiner des données : empiler deux tables de mêmes descripteurs (table1 + table2, en éliminant les doublons), et ajouter une colonne calculée (e["mention"] = ...).
6. Exemple résolu pas à pas
Correction · Question a
import csv
withopen("films.csv", "r", encoding="utf-8") as f:
films = list(csv.DictReader(f))
for film in films:
film["annee"] = int(film["annee"])
film["duree"] = int(film["duree"])
film["note"] = float(film["note"])
Correction · Question b
C'est une sélection à deux critères, suivie d'une projection sur le titre.
[f["titre"] for f in films if f["duree"] < 100 and f["note"] >= 7]
Correction · Question c
meilleur = films[0]
for f in films:
    if f["note"] > meilleur["note"]:
        meilleur = f
print(meilleur["titre"])
resultat = []
for f in films:
    for r in realisateurs:
        if f["titre"] == r["titre"]:
            resultat.append({"titre": f["titre"], "realisateur": r["realisateur"], "note": f["note"]})
Le programme complet, avec un petit fichier créé pour l'occasion :
withopen("films.csv", "w", encoding="utf-8") as f:
f.write("titre,annee,duree,note\nLe Voyage,2001,125,8.6\nLa Haie,1995,98,8.1\nPetit Monde,1998,74,7.5\nGrand Large,2009,104,6.9\n")
import csv
withopen("films.csv", "r", encoding="utf-8") as f:
films = list(csv.DictReader(f))
for film in films:
film["annee"] = int(film["annee"])
film["duree"] = int(film["duree"])
film["note"] = float(film["note"])
print([f["titre"] for f in films if f["duree"] < 100and f["note"] >= 7])
meilleur = films[0]
for f in films:
if f["note"] > meilleur["note"]:
meilleur = f
print(meilleur["titre"])
for f insorted(films, key=lambda f: f["annee"], reverse=True):
print(f["annee"], f["titre"])
À retenir
Révise ce chapitre avec KlarIA
Tuteur qui t'explique pas à pas, quiz pour t'entraîner, flashcards pour mémoriser. Gratuit.